
过去两年,具身智能技术加速演进。从机器人本体能力的持续突破,到具身基础模型的快速迭代,行业正逐步从技术验证走向真实场景应用。随着技术能力不断提升,如何实现规模化部署与商业价值转化,成为产业发展的重要议题。
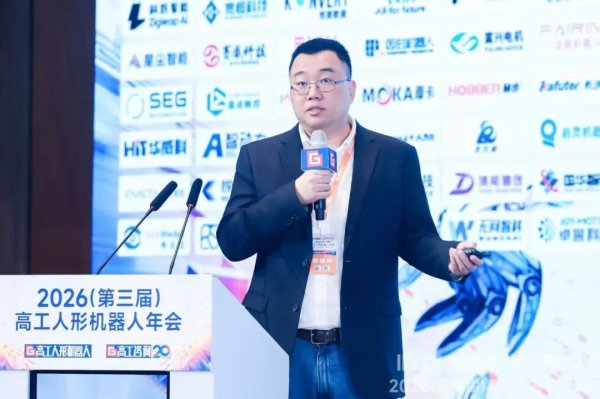
近日,在 2026 高工人形机器人年会上,原力无限(INFIFORCE)首席技术官王一舟围绕具身智能的技术演进与商业化发展,系统提出了 Data Scaling、Model Scaling 与 Deployment Scaling 三条 Scaling 分析框架。
这一框架从数据规模化、模型能力提升与场景部署三个维度,梳理了具身智能从技术研发走向产业应用的关键路径,也为理解具身大脑的技术进化与商业化发展提供了新的观察视角。
1 从技术突破到商业价值,具身智能如何跨越关键一程?
随着具身基础模型持续迭代,机器人在感知、操作和复杂任务执行等方面的能力不断提升。但从实验室走向真实生产环境,仍然需要解决模型泛化、场景适配和规模化部署等一系列问题。
在王一舟看来,具身智能的商业价值,既取决于当前的技术能力,也取决于技术进步的速度,以及新能力进入真实场景所需要的时间。
机器人的工作效率、运行稳定性和投资回报,都是衡量实际应用价值的重要指标。
2026 年 9 月,Anthropic 发布的研究《What Work Can Robots Do?》显示,在特定条件下,机器人已经具备完成相当比例体力工作任务的技术潜力,但真正具有成本竞争力的任务比例仍然有限。
这也意味着,具身智能需要在提升模型能力的同时,持续降低任务适配和场景部署成本,让技术进步更快转化为实际生产力。
围绕这一问题,王一舟将具身智能的 Scaling 归纳为三个维度:
Data Scaling:通过数据规模化,持续提升具身模型的能力。
Model Scaling:通过基座模型能力提升,降低新任务、新场景的适配成本。
Deployment Scaling:通过平台化与生态协作,推动具身智能规模化部署。
三条 Scaling 从技术研发延伸至产业应用,构成了具身智能规模化发展的重要路径。
2 Data Scaling:人类数据打开具身智能规模化的新空间
数据是具身智能发展的重要基础。
长期以来,机器人操作数据依赖真实设备与人工遥操作,采集成本高、效率有限,不同本体之间的数据也难以直接复用。
随着人类第一人称数据研究不断深入,具身智能正在获得新的数据规模化路径。
通过头戴式相机、动作捕捉等设备,可以在真实生活与生产环境中采集大规模人类操作经验,并通过模型训练探索向机器人能力的迁移。
近年来,多项研究已经展示了这一方向的潜力。
Dyna Robotics 发布的 Dyna-2 研究显示,当人类预训练数据从 1000 小时增加至 100 万小时,14 项真机任务的平均归一化得分由 20% 提升至 53%。
Physical Intelligence 的相关研究也表明,在特定训练条件下,人类操作数据能够改善机器人在真实任务中的表现。
在王一舟看来,人类数据的规模优势,与机器人数据的高精度交互特征具有互补价值。通过合理的数据结构与训练配方,两类数据能够共同推动具身基础模型能力提升。(这个观点原力无限首席科学家陈佳玉教授在浙江大学的讲座中也依然有提及)
围绕这一方向,原力无限持续开展 Ego-Centric 第一人称原生数据研究,并构建星河数据 DataGrid 全栈 AI Infra,覆盖数据采集、处理与模型训练等关键环节。
在 AtomEgo 研究中,原力无限联合高校研究团队,探索人类第一人称经验向机器人能力的迁移。在约 2659 小时数据的实验设置下,相关训练策略将真机任务成功率由 32.86% 提升至 51.43%。
从数据采集到模型训练,人类操作经验的规模化利用,为具身基础模型提供了更丰富的真实世界经验,也为跨本体能力迁移创造了新的可能。
3 Model Scaling:从模型能力提升到场景化后训练
如果说 Data Scaling 关注模型如何获得更多经验,那么 Model Scaling 更关注模型如何快速适应新任务、新环境。
过去,机器人进入新场景,通常需要重新采集大量示范数据,并通过模型微调完成任务适配。
随着具身基础模型的发展,Zero-shot、One-shot、Few-shot 等能力受到越来越多关注。
其中,In-Context Learning(ICL,上下文学习)允许模型通过上下文中的示范理解新任务,为减少额外训练投入提供了新的可能。
2026 年 8 月,Skild AI 发布 S1 模型。在其新任务泛化评测中,基于视频示范的 ICL 模型得分达到 66%,而语言指令模型为 9%。
Generalist 发布的 GEN-1.5 研究则展示了少量数据微调的潜力:在 10 项短任务中,仅通过一段示范进行适配,模型平均成功率为 59%;使用每项任务约 5 分钟的数据进行少量模型更新后,平均成功率提升至 83%。
这些研究展示了具身基础模型在泛化能力与低成本适配方面的进展。
在王一舟看来,基座模型的价值不仅体现在能够完成多少任务,更体现在进入新任务时,需要多少额外的数据与训练成本。
围绕这一方向,原力无限致力于打造全球领先的通用具身大脑 AtomBrain,以隐式世界模型为核心技术路线,围绕具身基础模型、大小脑协同与场景化后训练构建完整技术体系,持续提升机器人在复杂环境中的自主决策与任务执行能力。
在已有研究中,原力无限自主研发的 AtomVLA 具身模型,在 LIBERO 基准测试中取得 97.0% 的平均成功率,并在真实机器人上完成叠 T 恤、折毛巾等柔性物体操作任务;世界与动作统一建模框架 AIM 在 RoboTwin 2.0 基准测试中取得 93.1% 的平均成功率。
围绕持续学习、动作微调与场景化后训练,原力无限持续探索利用更少的任务数据,让基座模型快速获得新能力,推动具身大脑适应不同机器人本体与真实应用场景。
4 Deployment Scaling:从样板部署到生态规模化复制
随着数据与模型能力持续提升,具身智能的规模化部署也迎来新的发展机会。
2026 年 10 月,Physical Intelligence 发布 Pi API beta,向开发者开放数据上传、模型微调与托管推理等能力,探索具身基础模型的平台化服务模式。
在王一舟看来,具身大脑的规模化部署可以借鉴软件和人工智能行业的 FDE(Forward Deployed Engineering,前线部署工程)模式。
通过 FDE 深入关键客户与典型场景,完成技术验证和样板部署,再将模型能力、工具体系与部署经验沉淀为标准化平台,赋能行业集成商及生态伙伴,实现跨场景的规模化复制。
随着基座模型能力提升与场景适配成本下降,具身大脑有望通过平台化与生态协作,加速进入更多真实生产环境。
在产业实践方面,原力无限围绕通用具身大脑 AtomBrain,持续推进场景化后训练与真实环境部署。目前,公司已在工业、商业服务等多个领域开展业务实践,推动机器人在仓储拣选、工业操作等任务中的应用验证。
通过真实场景中的模型适配、任务执行与数据反馈,原力无限持续积累具身大脑的场景化应用经验,推动核心技术成果向实际生产力转化。
5 从 Data 到 Deployment,走向真实生产力
具身智能正在进入技术能力与产业应用协同发展的新阶段。
随着真实世界数据不断积累、具身基础模型持续迭代,以及场景化后训练与部署体系逐步成熟,机器人获得新能力、适应新环境的效率有望持续提升,规模化应用也将拥有更加坚实的技术基础。
这也是王一舟提出三条 Scaling 框架的核心思考:让数据规模的增长推动模型能力进化,让模型能力的进化降低场景适配成本,最终形成能够持续扩展的产业应用能力。
围绕这一方向,原力无限将持续推进通用具身大脑 AtomBrain 的技术创新与真实场景实践,加速具身智能从技术突破走向规模化应用。
(来源:原力无限)
资讯评论 (0)
全部评论
暂无评论,来发表你的看法吧