
人走进陌生的世界,一边探索,一边记住来路。转过街角,目标虽然离开视野,却没有从记忆中消失;走得再远,仍能凭沿途所见找到返回的方向。
“我们一切探索的终点,将是回到出发的地方。”
——T. S. 艾略特
机器人的下一步,是走进没有为它预先安排好的世界。
从楼宇服务到园区巡检,从地面行走到空中探索,机器人需要在变化的环境中理解指令、寻找目标,并在需要时返回此前经过的位置。让每一步积累的经验持续参与行动,是机器人从完成一次演示,走向独立承担真实任务的重要一步。
近日,源策未来牵头,联合香港大学 OpenDriveLab、上海创智学院、硅羽科技(Spatial Robotics)、华为等研究团队,正式推出面向开放世界的具身导航基础模型 Compass 1。模型以单目 RGB 视频作为视觉输入,统一语言理解、视频 — 动作联合生成与长期空间记忆,让机器人能够理解并执行多阶段指令、主动探索当前视野之外的目标,并利用接近两分钟的视觉历史找回此前经过的位置。
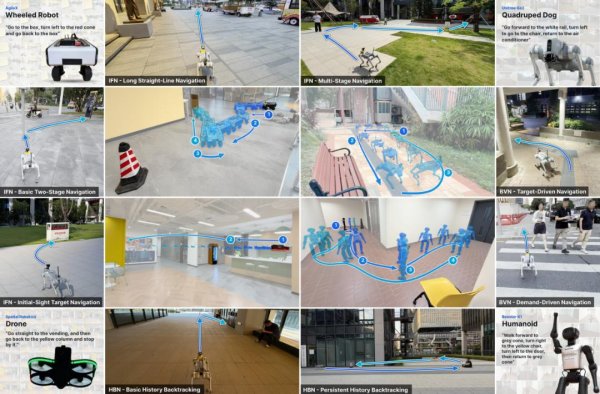
Compass 1 已在四种不同机器人本体上完成真实世界验证。在宇树 Go2 真机测试中,模型取得 79.4% 的整体成功率,显著领先最强基线的 17.8%;在高难度持续历史回溯任务中,成功率从对比方法的 0% 提升至 58%。同一模型还实现了向轮式机器人、人形机器人及无人机的零样本迁移,无需针对新平台额外微调,并在室内外及行人与车辆动态干扰的场景中接受检验。
继聚焦精准、稳定全身控制的 Anchor 1 之后,Compass 1 将源策未来的全身智能探索进一步延伸至开放世界中的空间理解与持续导航:Anchor 1 关注机器人如何精准、稳定地执行动作,Compass 1 关注机器人如何理解任务、探索环境并记住路径。两项工作从身体执行与空间智能出发,共同推进机器人在更广泛的真实场景中持续、可靠地完成任务。
01 核心能力 听懂指令,探索未知,循迹返回
持续理解并执行多阶段指令
传统短时导航任务往往只需要到达一个目标,但现实中的任务可能包含多个连续阶段。Compass 1 将任务阶段理解与连续动作预测结合,使模型能够在执行过程中持续判断当前进度,而不是每一步都重新从当前画面猜测任务目标。
探索视野之外的世界
开放世界中的目标并不总是直接可见,机器人需要主动探索环境,并随着新观察的出现不断更新判断。这要求模型能够保持跨越多个决策时刻的探索意图,减少重复探索与无效转向。
利用历史记忆重新找到目标
历史回溯进一步提高了导航难度,目标可能早在几十秒前就已经离开视野。Compass 1 支持利用接近两分钟的视觉历史,使机器人能够在更长的任务过程中保留并使用此前的环境信息。
02 三类真实场景 从机器狗到无人机与动态街道
香港大学|校园多场景泛化
在香港大学的实物验证场景中,宇树 Go2 四足机器狗搭载约 0.5 米高度的第一人称相机,在室内外完成语言指令跟随、开放空间探索与历史回溯。四足运动带来的机身抖动,以及不同于训练数据的视角高度,使模型必须在变化的画面中持续判断位置与目标。
机器狗的演示把三类能力串联起来:遇到死胡同后转身脱困,面对多阶段指令按顺序执行,再根据历史画面返回此前的目标位置。它考验的不只是单次转向是否正确,还包括连续行走后,机器人能否记住已经完成的步骤与已经经过的目标。
硅羽科技|零样本地空迁移
Spatial Robotics 的无人机测试,把同一导航能力从地面带向空中:摄像头由约 0.5 米抬升至 1.5 米,视觉尺度、运动方式和观察视角随之变化。在主要以约 1.0 米相机高度数据训练的条件下,Compass 1 无需针对这些新本体额外训练,仍能执行导航任务。
这一测试的关注点,是模型能否在身体和视角变化后继续利用空间信息。对于从四足平台走向空中平台的导航研究,跨本体迁移提供了一个可观察的起点,也为后续扩大平台和场景验证留下空间。
源策未来|人车干扰下持续导航
从室内走到街道,导航面对的不只是路线变化,还有动态行人与车辆带来的干扰。真实测试覆盖了动态街道,也展示了以车辆为环境目标的导航案例。这类场景将问题推进到更开放的环境:机器人需要在变化的视觉信息中持续理解指令,并保持对目标与路径的判断。
在动态干扰中,历史信息的作用更加直观:短暂遮挡或背景车辆移动,不应让机器人忘记自己正在执行的阶段。团队对四类环境分别统计结果,用街道场景检验这类干扰下的导航表现,也为后续评估更复杂开放环境提供参照。
03 核心技术 如何让历史信息真正参与行动
Key 1|HRM:把路径变成记忆
历史表征地图 HRM 将动作轨迹、朝向与关键帧位置组织到一张图中,帮助模型同时理解 “看见了什么” 和 “走到了哪里”。关键帧采样减少重复输入:一分钟、4 FPS 的约 240 帧视频,平均压缩为约 40 个关键帧,并保留重要转弯与目标信息。部署时,机器人控制误差可能造成微小的动作输出实际不发生转动或转动过大,使得连续历史帧呈现严重非均匀分布。根据前进距离和转角设置阈值保留关键帧能够有效降低该问题。
Key 2|VQA:让记忆参与决策
结构化视觉问答训练模型判断任务执行到哪一步、哪些方向已经探索,以及历史目标出现在哪里。三类监督分别支撑指令跟随、自主探索与历史回溯,使空间记忆能够参与下一步行动判断。
Key 3|AR+DM:推理与动作生成协同
统一多模态骨干将语言推理与视频 — 动作生成结合;部署时通过单 GPU 异步执行协调动作生成、任务阶段与停止条件判断,让机器人在连续运动中保持任务与执行的一致性。
团队构建半自动视频标注流程,将运动轨迹、阶段指令、关键帧与目标定位监督对齐,整理超过 500 小时高质量真实交互数据与超过 2,000 小时标注网络视频,为持续导航提供可扩展的训练基础。
04 实验验证 数据说话:从 “能导航” 到 “持续导航”
团队在办公室、露台、建筑群与街道四类真实环境,围绕八类任务开展对比;每种方法累计进行 320 次测试。Compass 1 整体成功率为 79.4%,对比方法中排名第二的成功率为 17.8%。在初始可见目标导航、基础两阶段导航等任务上分别达到 98% 和 93%;目标驱动探索与需求驱动探索成功率分别为 85% 和 83%。
尤其值得关注的是持续历史回溯:机器人沿着多阶段路径前进后,仍需要根据此前的视觉记忆找到已经离开视野的目标。该项任务成功率达到 58%;测试还展示了接近两分钟的历史视觉回溯能力。
05 长期布局 走向更多真实世界
Compass 1 从机器狗的真实环境验证,到无人机的跨本体测试,再到动态街道中的导航探索,多方研究共同指向一种能力:让机器人在不同身体和场景中,持续理解任务、利用历史并执行行动。
Compass 1 并不是源策未来对具身智能的全部回答。在公司此前发布的《Whole-Body Intelligence: The Pretraining Path to Large Humanoid Models》中,源策未来提出:机器人技术真正需要跨越的,不只是完成某个精心准备的演示,而是随着数据、部署经验和硬件迭代,持续提升跨场景、跨任务的能力。
在源策未来官网介绍的模型技术栈中,S2 负责语言、任务语义、记忆和长程规划;S1 学习融合视觉、身体状态和触觉等信息的原生人形机器人表征;S0 则面向真实硬件完成平衡、接触和控制跟踪。三层并非三个孤立的产品,而是对从 “理解要做什么” 到 “身体如何可靠完成” 的职责划分。
在身体控制层面,源策未来此前发布的 Anchor 1,用校准后的稀疏运动参考保留动作意图,并将执行误差反馈独立用于纠偏,支持精准、稳定的全身运动。降低执行层的不确定性,才能更清晰地检验上层策略的判断是否有效,并区分任务中的偏差来自环境理解、动作生成,还是身体控制。
这也是源策未来将数据、模型、控制与评测放在一起推进的原因。机器人在真机任务中积累的成功经验与失败反馈,可以帮助团队判断下一步该补充什么数据、改进哪一层能力。从 Compass 1 到 Anchor 1,源策未来正持续连接空间智能与全身控制,推动机器人从理解世界走向自主行动。让真实部署持续推动系统迭代,迈向可规模化应用的通用物理智能,是两项工作背后共同的长期方向。
(来源:源策未来)
资讯评论 (0)
全部评论
暂无评论,来发表你的看法吧