
近日,智元正式发布 WITA-Omni(硅光动语全模态大模型)—— 行业首个具身全模态端到端交互大模型。不同于智能手机、音箱和座舱,机器人面对的交互场景更加复杂,包括更嘈杂的环境、更多变的交互对象、更远的交互距离、更频繁的位置变化等。WITA-Omni 基于机器人本体感知数据深度训练,除了音视频输入输出,还新增支持触觉、本体状态等输入,以及机器人动作、表情等输出,让机器人第一次拥有为物理世界而生的 "交互大脑"。
01/ 八大核心能力 构筑全模态交互领先实力
在最近举办的智元创新日(AI Day)现场,智元联合创始人、联席总裁、中央研发部总裁、交互业务体系总裁熊彦与搭载了 WITA-Omni 的智元远征 A3-Ultra 进行了长达十分钟的实时互动,现场上演极限压力测试,WITA-Omni 全程稳定表现,充分展现了 WITA-Omni 在极速响应、全模态拒识、语言大咖、超强拾音、灵动情感、智能面屏、全时自主、本体部署方面的八大核心能力。
超强拾音
针对自身噪声干扰、目标移动、嘈杂环境与多人混叠等难点,WITA-Omni 自研视听融合感知前端:结合本体状态消除回声与自噪声,持续锁定移动中的交流对象,融合声纹、唇动与视觉定位提取目标语音、抑制环境噪声。
极速响应
基于流式全双工架构,WITA-Omni 可做到边听、边想、边应、边动、边做表情,减少传统串行处理中的等待。交互响应最快约 400 毫秒、平均约 600 毫秒,较业内平均水平快近 3 倍。
全模态拒识
全模态拒识让机器人交互不再需要唤醒词,全程自然对话。系统结合对话朝向、视频、音频、声纹、唇动、姿态、语义和上下文,决策当前发言是否需要回应。面对多人交谈或环境广播等干扰时,极大降低误触发,让机器人更懂 "看场合"。
语言大咖
WITA-Omni 支持上百种语言和方言的免切换自由交流,并结合全双工架构,实现了流式同声传译(语言传译 & 方言传译),以及双向互译。
灵动情感
WITA-Omni 情感表现力更加拟人。倾听时,通过细腻的表情和自然的头部动作给予回应;表达时,结合参数化的面部表情、富有感染力的声音与协调的肢体动作,生动呈现开心、惊讶、激动、悲伤、满意、痛哭、认真与自信等几十种情绪。每种情绪还能展现不同强度:同样是开心,既可以浅浅一笑,也可以开怀大笑,让对话更真实、更有温度。
Intelligent FaceUI 智能面屏
WITA-Omni 不仅能说、能看、能动,还能画,当我们想讲一个复杂产品时,或想给孩子讲个科普小知识时,WITA-Omni 会智能决策,将一言难尽的内容在面部屏幕实时可视化出来,让用户一目了然。
全时自主
WITA-Omni 能够持续感知周围环境、用户状态及其变化,自主思考、决策并采取行动,在恰当时机主动发起互动。机器人有自己的小心思:见到贵宾,会主动欢迎、伸手握手;收到点赞,会开心回应;看到用户挥手告别,也会立刻挥手相送。
本体部署
基于智元远征 A3-Ultra 的强大算力和大量推理优化,WITA-Omni 是业内首个实现在量产机器人本体部署的大参数量模型,有效解决隐私保护、无网交互、以及实时计算的问题。
02/ 四大权威榜单登顶 底层范式重构交互模式
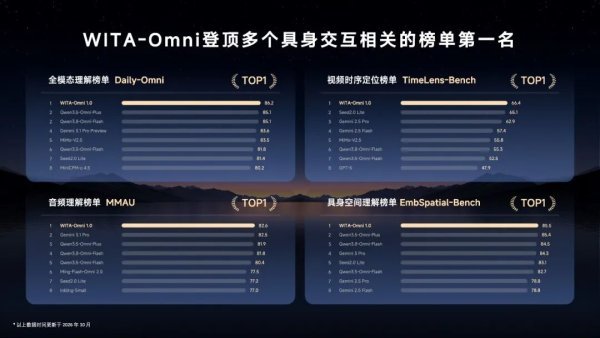
WITA-Omni 已登顶多个具身交互相关的权威榜单:全模态理解榜单 DailyOmni、视频时序定位榜单 ActivityNet-TimeLens、音频理解榜单 MMAU、具身空间理解榜单 EmbSpatialBench,全面体现了其在具身全模态交互领域的技术领先性。
支撑 WITA‑Omni 强大交互能力的背后,是一套面向机器人原生打造的底层技术体系。从训练范式、交互机制到快慢双引擎架构,层层打通感知、理解与行为输出,让机器人的对话不再是简单文字转语音,而是和实体动作深度绑定的连续交互过程。
具身交互训练范式:全模态预训练、具身行为对齐、交互策略强化
WITA-Omni 从底层为机器人交互原生设计:视觉、听觉、语言、表情、动作统一建模。全模态预训练打下跨模态理解的基础;具身行为对齐基于机器人本体数据,让模型的语音、表情与动作输出贴合本体能力;交互策略强化则让机器人学会何时回应、接话、让话与主动交流。
流式全双工:边倾听、边理解、边回应
系统流式接收输入,同步流式生成语音、表情与动作,听说并行倾听时即有点头、注视等反馈。实时判断用户是暂时停顿还是已经说完,把握应答、插话及让话时机,实现低时延接续与随时打断。
快交互 × 深思考:基础任务即时交互不中断,复杂任务云端深度思考
针对对话要求响应要快,复杂任务却需要长时思考的矛盾,WITA-Omni 采用快慢双模系统:前台 Interaction Engine 流式理解、即时回应,后台 Background Agent 负责推理、规划、工具调用与长程任务。两者共享上下文与时间线,用户可随时补充、纠正或取消,后台任务实时调整。
03/ 从实验室走向上岗部署态场景规模化验证
在智元 "三智一体" 的产品技术架构中,交互智能是机器人部署态落地,进入真实作业场景的重要能力之一。交互智能的发展,能够让人形机器人更好地融入及服务人类社会。在部分文娱导览等场景中,搭载了 WITA-Omni 的智元机器人以流畅自然的应答交互和游客趣味互动,承担了知识讲解、乐园导览等工作,完成了面向公众开放环境下的交互任务。
WITA-Omni 的正式发布,标志着行业在交互智能领域迎来了代际突破。未来,智元将持续加码交互智能研发,推动机器人不止 "能动会干",更能 "懂人、会交流",让物理 AI 走入万千场景,助力 "部署态" 加速落地,让机器人成为人类可靠的协作伙伴。
(来源:智元)
资讯评论 (0)
全部评论
暂无评论,来发表你的看法吧