
在本届 CoRL 中,极佳视界多项研究成果入选,涵盖世界模型、具身操作、视觉导航等,分别从数据生成、策略后训练和实时导航切入,回答 “世界模型如何真正进入机器人的学习与决策闭环”。
第十届国际机器人学习会议(Conference on Robot Learning,CoRL 2026)于 11 月 9 日至 12 日在美国得克萨斯州奥斯汀召开,CoRL 是机器人与机器学习交叉领域最具学术影响力的顶级会议之一。
据 CoRL 官方公布,CoRL 2026 收到了创新高的 2094 份有效投稿(比 CoRL 2025 增加约 184.1%),共录用了 687 篇论文,接收率为 32.8%。在本届 CoRL 中,极佳视界多项研究成果入选,涵盖世界模型、具身操作、视觉导航等多个领域,本文将对其中四篇精选论文进行详细解读。这四项工作分别从数据生成、策略后训练和实时导航切入,回答 “世界模型如何真正进入机器人的学习与决策闭环”。
SKIP 抓住关键帧,高效生成机器人操作视频
SKIP 由极佳视界联合中国科学院自动化研究所、中国科学院大学、南京大学、清华大学等单位提出,研究成果入选 CoRL 2026。该框架通过稀疏关键帧生成与动作条件插值,让具身世界模型在保留关键操作事件的同时,高效生成完整的机器人操作视频。在 LIBERO 基准上,SKIP 相比稠密生成基线实现 4.16 倍加速,FVD 降低 89.0%;进一步利用生成视频训练机器人策略,即使完全替换策略训练中的真实演示视频,仿真和真机成功率也仅分别下降 1.3 和 6.7 个百分点,为高质量机器人合成数据的构建提供了新的技术路径。
论文链接:https://arxiv.org/pdf/2606.00664
项目主页:https://zihenghe04.github.io/SKIP/
具身世界模型能够预测机器人执行动作后的场景变化,为策略学习提供合成数据,并支持操作过程的可视化预览。然而,现有视频生成方法通常需要在整段操作轨迹上进行稠密扩散计算,大量相似的背景和连续运动增加了生成成本。直接减少视频帧数,又容易遗漏夹爪闭合、接触物体和释放等关键事件。这些变化可能只涉及少量像素,却决定了机器人能否正确完成抓取与放置。如何在提升生成效率的同时保留完整的任务信息,成为具身世界模型走向实用的重要问题。
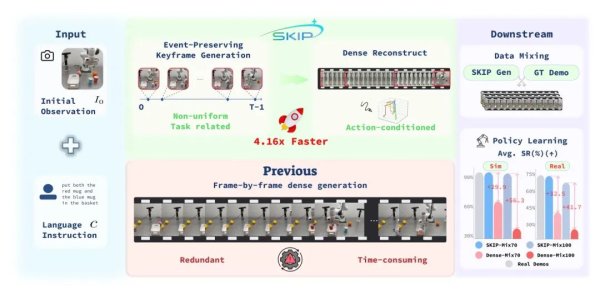
针对这一挑战,SKIP 将完整视频生成拆解为关键帧生成与连续视频重建两个阶段。模型首先根据初始图像和语言指令,生成保留关键操作事件的稀疏画面,再结合机器人动作恢复中间过程。这种从稀疏关键事件出发的生成方式,将主要计算集中在与任务相关的画面上,同时保留可直接用于策略训练的完整视频。
SKIP 的总体结构如下。训练阶段,关键帧选择模块 SKIP-Selector 融合光流、语义与可选的机器人本体状态,结合时序分割和夹爪事件保护,从演示视频中提取关键画面。随后,基于 Wan 2.2 微调的 SKIP-Generator 学习这些稀疏序列,在推理时根据初始图像和语言指令直接生成关键帧。最后,SKIP-Reconstructor 预测相邻关键帧的时间间隔,并通过动作条件插值器 AC-FILM 补全中间画面,使恢复的视频与机器人动作相对应。
在实验中,在需要连续操作多个物体的长时程任务中,均匀采样、几何简化或通用视觉特征方法可能遗漏关键的持物状态,进而影响后续视频重建。相比之下,SKIP 能够更好地保留物体被夹持、移动与放置过程中的状态变化,使生成视频中的关键操作信息更加完整。这表明,面向机器人任务的关键帧选择,对于合成数据的质量具有直接影响。
在定量实验中,研究团队在 LIBERO 的四个测试套件上,对生成视频的像素质量、感知质量与视频分布进行评估。SKIP 在 PSNR、SSIM、LPIPS 和 FVD 指标上均优于论文中的对比方法。其中,相比逐段递归生成的稠密 Wan 2.2 基线,SKIP 将总体 FVD 从 4177 降至 458,降低 89.0%,在减少生成计算的同时提升了视频质量。
除了生成质量,SKIP 还显著提升了长时程操作视频的生成效率。在单张 H20 GPU、50 步去噪和 bf16 精度的相同设置下,按轨迹数加权的平均生成时间从 157.37 秒缩短至 37.86 秒,实现 4.16 倍加速。在长时程任务更为集中的 LIBERO-10 套件上,加速比达到 6.13 倍,为更高效地构建机器人训练数据提供了支持。
不仅如此,为验证生成视频能否用于机器人学习,研究团队进一步在 LIBERO 仿真环境和 Franka Panda 真机上训练并测试 π0.5 策略。当 70% 的训练视频由 SKIP 生成时,仿真与真机平均成功率相对全真实演示训练的差距均不足 1 个百分点;即使训练视频 100% 使用 SKIP 合成,平均成功率仍分别达到 93.9% 和 67.5%,仅下降 1.3 和 6.7 个百分点。相比之下,相同替换比例下的稠密生成基线成功率分别为 37.5% 和 25.8%,体现了保留关键操作事件对于策略学习的重要性。
上述真机实验在固定第三人称视角的单臂操作场景中开展,每项任务进行 30 次闭环测试。合成视频基于已有演示训练的模型生成,并与专家动作序列配对用于策略学习。实验结果表明,SKIP 既能够提升视频生成效率,也能够保留对机器人学习有用的操作信息,使合成视觉数据在本文评估的任务中发挥接近真实演示视频的训练价值。
高质量训练数据是具身智能持续发展的重要基础。SKIP 将关键事件建模、高效视频生成与机器人策略学习连接起来,为世界模型作为数据引擎提供了新的实践。通过减少连续视频中的冗余计算,并在仿真与真机上验证合成视频的训练效果,这项研究为构建更高效的机器人数据生产流程提供了依据,也为后续探索多视角、双臂操作及更复杂任务中的合成数据应用奠定了基础。
WAM-Nav 一边规划动作,一边预测未来视觉
极佳视界联合南京大学、中国科学院自动化研究所和清华大学等单位提出 WAM-Nav,已入选 CoRL 2026。该工作将世界模型的视觉预测能力融入导航策略,通过共享生成模型联合规划动作与预测未来视觉,以 “长动作计划、短期视觉前瞻” 的设计,支持图像目标导航、坐标目标导航和无目标探索。
论文链接:https://corl-2026-wam-nav.github.io/WAM-Nav/static/pdfs/WAM-Nav.pdf
项目主页:https://corl-2026-wam-nav.github.io/WAM-Nav/
视觉导航要求机器人在复杂环境中生成可执行的运动轨迹。现有反应式策略通常直接从观测生成动作,缺少对未来视觉的显式预测;分阶段引入世界模型的方法虽然提供了前瞻信息,但也可能增加推理开销及对预测误差的敏感性。同时,导航中的大幅视角变化,使长时间的未来视频预测更加困难。针对这些问题,WAM-Nav 将动作与视觉前瞻放入同一个生成过程,让两类信息在模型内部直接交互。
WAM-Nav 的整体框架包含统一目标对齐、双流上下文和非对称联合生成三个部分。首先,模型将不同目标编码为视觉语义与几何查询,分别提供外观和方向线索,并通过对比学习对齐指向同一终点的图像与坐标。随后,双流上下文机制结合历史视觉观测与相对运动轨迹,综合考虑 “看到了什么” 和 “刚才怎样移动”,形成目标相关的生成条件。
在生成阶段,共享 Diffusion Transformer 同时预测 24 步动作序列与 1 帧未来视觉潜变量,动作和视觉 token 在各层自注意力中交互。较长的动作窗口提供连续的轨迹计划,短期视觉前瞻则提供近未来感知信息,避免多步自回归视觉展开。模型采用流匹配训练,并在执行轨迹前段后,根据新观测持续更新计划。
在 ClutterScenes 和 InternScenes 的零样本仿真评测中,WAM-Nav 的图像目标与坐标目标导航成功率分别达到 50.2% 和 80.4%,相较 NavDP 分别相对提升 15.7% 和 3.3%;无目标探索面积达到 171.1 平方米。上述结果均为四类场景的等权宏平均。消融实验进一步表明,共享动作 — 视觉交互及短期视觉预测有助于提升导航表现。
WAM-STEP 让训练期的视觉想象成为策略自提升的信号
WAM-STEP 由极佳视界联合香港科技大学(广州)、中国科学院自动化研究所、清华大学、中国科学院大学等单位提出,研究成果入选 CoRL 2026。该框架面向高效世界动作模型(WAM),将原本仅用于训练的视觉分支转化为内生想象模块,通过分支解耦的后训练实现策略自提升,且部署时仍保持纯动作推理、无需生成视频。在 RoboCasa365 上,WAM-STEP 将基座策略平均成功率从 20.7% 提升至 24.0%(+3.3 个百分点,额外 83 个成功回合);在两项真机任务上平均成功率达 62.5%,较基座策略提升 20 个百分点,为高效 WAM 的后果反馈式后训练提供了新的技术路径。
论文链接:https://openreview.net/forum?id=1u6oriJJcU
世界动作模型通过预测未来视觉后果增强机器人策略,但推理阶段生成视频会显著增加控制延迟。近期高效 WAM 将视觉分支仅用于训练、部署时只保留动作策略,避免了在线视频开销;然而,预测未来多只作为辅助模仿损失,并未直接参与策略改进。若再引入独立世界模型做强化学习,又会带来额外对齐与系统复杂度。如何在不增加推理视频生成的前提下,把训练期视觉后果转化为策略提升信号,成为高效 WAM 走向实用的关键问题。
针对这一挑战,WAM-STEP 提出两阶段后训练。Stage I 用含成功与失败的策略 rollout 校准视觉分支,并引入动作条件偏好损失(Acpre),使未来预测更忠实跟随动作后果;Stage II 冻结视觉分支,对想象轨迹进行奖励打分,结合策略锚点稳定更新动作分支。推理阶段仅使用动作分支,保持高效部署。
实验中,WAM-STEP 在 RoboCasa365 官方划分上优于多项基线及同设定复现的 VLAW*;消融显示,去掉 Acpre 或策略锚点后性能均下降,说明二者对动作对齐与稳定更新缺一不可。真机方面,在 AgileX PiPER 上完成折叠衣物与加热食物两项任务,成功率分别为 60% 与 65%,平均 62.5%,验证了该方法向真实接触操作的迁移能力。
WAM-STEP 将训练期视觉后果转化为可部署策略的自提升信号,为高效世界动作模型的后训练提供了一条简洁可行的路径。
EMMA 从生成更多数据,到更有效地利用数据
EMMA(Embodied Manipulation Media Adaptation)由极佳视界联合北京大学、清华大学、中国科学院自动化研究所等单位提出,是一种融合生成式视觉数据引擎与自适应训练策略的具身操作 VLA 模型增强框架。EMMA 通过创新性地结合多视角视频生成模型 DreamTransfer 与难例感知训练策略 AdaMix,进一步提升视觉 - 语言 - 动作(Vision-Language-Action,VLA)模型在未知物体外观和复杂视觉环境下的泛化能力。
实验结果表明,DreamTransfer 相比现有方法在多视角一致性和几何一致性方面分别提升了 42% 和 24%。在真实机器人零样本视觉泛化测试中,引入生成数据使 VLA 策略的任务成功率相较于仅使用真实数据训练实现了 92% 的相对提升,结合 AdaMix 训练策略后进一步获得 17% 的相对提升。EMMA 为解决具身智能领域的数据稀缺与视觉泛化难题提供了一条有效的技术路径。
论文链接:shturl.cc/TmgZO4cmnIq7pelx1xxdRSBvYqqFHq
项目主页:https://emma-gigaai.github.io/
VLA 模型是推动具身智能发展的重要技术方向,在真实机器人训练中,操作数据通常依靠人工遥操作采集,存在成本高、效率低、场景覆盖有限等问题。与此同时,即使机器人已经学会某项操作,当物体的颜色、材质、纹理或环境光照发生变化时,模型仍可能出现操作失败。虽然仿真平台可以低成本生成大量操作数据,但仿真环境与真实世界之间存在视觉域差异(Sim-to-Real Gap),使得仿真数据训练的策略在真实环境中容易出现性能下降。近年来,生成式视频模型为具身数据扩增提供了新的解决思路,但现有方法仍面临两项关键挑战:生成视频难以同时保证多视角一致性与三维几何合理性,并且如何高效利用生成数据进行 VLA 训练仍缺乏有效解决方案。
针对上述问题,本文提出 EMMA 框架,将 “高质量具身数据生成” 与 “高效率策略学习” 有机结合,不仅能够生成具有丰富外观变化的机器人操作视频,还能够根据策略模型的实际表现动态优化训练数据分布,从而提升机器人面对未知视觉环境时的操作鲁棒性。
EMMA 的整体框架主要由 DreamTransfer 和 AdaMix 两个核心模块组成。DreamTransfer 负责生成多视角一致、几何一致的具身操作数据,AdaMix 负责高效利用数据。
首先,DreamTransfer 以真实或仿真机器人操作视频对应的深度信息和文本描述作为控制条件,通过生成式视觉模型改变场景中物体的外观、背景及光照条件,生成具有多视角一致性和几何一致性的操作视频。随后,EMMA 通过视频质量筛选模块,从多视角一致性、几何一致性以及文本 - 视频语义匹配度等维度评估生成视频,筛选出适合 VLA 模型训练的高质量数据。最后,将筛选后的生成数据与真实数据共同用于 VLA 策略训练,并引入 AdaMix 自适应采样机制,根据模型在不同样本上的动作预测表现动态调整训练权重,使模型更加关注具有挑战性的操作场景。
在定量实验中,DreamTransfer 的多视角一致性相比 SOTA 方法提升了 42%,在多视角一致性、几何一致性及文本语义控制方面展现出了综合的优势。
为了验证 EMMA 在真实机器人上的应用效果,研究团队基于 Agilex CobotMagic 双臂机器人平台,在 π0 和 π0.5 两种 VLA 模型上进行了系统评估。真机任务包含了衣物折叠、桌面整理和丢弃瓶子等任务,覆盖了刚性与柔性物体操作,以及不同时间跨度和操作精度要求的机器人技能。实验结果表明,EMMA 能够显著提高机器人在未知视觉外观条件下的操作成功率。综合三项任务,π0.5 模型的平均成功率由 43.3% 提升至 82.5%。对于 π0 模型,平均成功率也从 30% 提升至 79.2%。
从 “生成更多数据” 到 “更有效地利用数据”,EMMA 为具身智能 VLA 模型的高效训练与跨场景泛化提供了新的思路。随着生成式视觉模型、多视角空间建模与机器人策略学习技术的持续发展,这一方向有望进一步推动具身操作在复杂真实环境中的鲁棒性和实用性,为通用机器人智能的发展提供重要支撑。
世界模型 通往物理世界的三条路径
从这四项工作可以看到,世界模型正在从 “预测画面” 走向机器人学习的多个环节:SKIP 与 EMMA 用它生成可直接训练策略的合成数据,WAM-STEP 把训练期的视觉预测转化为策略自提升的信号,WAM-Nav 则让预测与决策在同一个模型中实时交互。数据引擎、训练信号、决策内核 —— 这是世界模型通往物理世界的三条路径,也是极佳视界持续投入的方向。
未来,极佳视界将继续以世界模型为核心,推动前沿研究与真实场景中的机器人学习相互促进,让面向物理世界的通用智能走得更稳、更远。
(来源:极佳科技)
资讯评论 (0)
全部评论
暂无评论,来发表你的看法吧