11 月 13 日,Vbot 维他动力正式发布跨视角数据生成模型 Exo2EgoPolicy、端到端通用数据管线 Vbot Echo,并同步推出配套数据采集应用 Echo App。
通过跨视角视频生成、端到端数据处理与以及低门槛的真实场景采集,Vbot 打通从数据获取、生成处理到机器人训练数据产出的完整链路,让海量通用第三视角视频与真实世界的人类操作经验转化为机器人可利用的训练数据,构建具身智能规模化数据生产体系。
01. Vbot 解决的问题
具身智能行业长期受数据问题困扰。为在更低成本下采集更多数据,业界尝试了多种采集方式 —— 真机遥操作、ALOHA、UMI、第一人称(Egocentric)视频等。然而,穿戴式采集设备不仅增加了硬件成本,还拖累了操作员在真实场景中的作业效率。行业始终缺少一种既能满足数据多样性(Diversity)、又能获得海量规模(Scale)的数据方案。
Vbot 将目光投向了规模最大、来源最广的视频数据 —— 互联网。互联网视频天然丰富多样、体量巨大,但绝大多数是第三人称视角,而非具身智能所需的第一人称视角。在人类已经构建的视频世界中,YouTube 平均每天新增超过 2,000 万条视频 (YouTube 官方数据);TikTok 在 2025 年 11 月披露,每天有超过 1 亿条内容上传(TikTok 官方公告)。若能有一个模型,精准地把海量互联网视频转换为第一人称视角视频,就有望真正破解具身智能的数据难题。Vbot Exo2EgoPolicy 正是在这样的背景下诞生的。
02.Exo2EgoPolicy:让海量第三视角视频成为机器人学习资源
Vbot 发布的 Exo2Ego Policy Model 是面向真实操作场景的跨视角视频生成模型,能够将第三视角中的人物动作、物体交互和场景信息转化为对应操作者的第一视角画面。其核心价值在于,让原本并非为机器人训练而采集的海量通用视频,能够转化为更贴近机器人观测条件的学习素材,拓宽具身智能训练数据的来源。
在技术实现上,Exo2EgoPolicy 以视频生成主干为核心,结合视觉编码与语义理解,建立第三视角和第一视角之间的动作联系:识别谁在操作、双手如何运动、正在接触什么物体,以及操作如何随时间展开。在此基础上,模型联合生成连续画面中的空间结构与外观细节。
围绕真实视频的复杂性与机器人学习的数据需求,Exo2EgoPolicy 具备两项核心技术优势:
兼容复杂的互联网视频。面对多人同框、拍摄角度变化和镜头切换,模型结合人物、动作与场景线索理解操作过程,并支持指定目标角色,使第一视角生成围绕同一操作者展开。
提升几何结构与纹理细节的还原质量。训练中引入相机几何、手部结构和真实操作数据,帮助模型学习物体的空间布局、双手与物体的接触关系,以及跨视角的外观对应。这些约束共同支持更合理的结构、更清晰的材质细节和更连贯的运动表现。
在实际使用中,仅需输入第三视角视频,无需额外提供深度数据或相机标定信息,即可完成跨视角视频生成。
03. 行业现状 & 突破:机器人训练数据规模化生产的三大瓶颈
随着具身智能向更广泛的真实场景拓展,如何利用海量人类视频数据训练机器人,正在成为行业的重要研究方向。Physical Intelligence 的人类视频迁移研究、NVIDIA 的 EgoScale 等代表性工作,已将第一视角人类视频用于机器人训练,并通过动作表示、数据对齐等方式推动经验迁移。人类示范正在成为机器人数据的重要补充,但如何让更多类型的视频真正服务动作学习,仍是需要持续突破的问题。
视频能够被机器人理解,并不意味着其中的动作能够直接用于机器人训练。 现有互联网视频虽然包含丰富的任务语义与人 — 物交互信息,却通常缺少机器人所需的动作控制信号与物理交互信息。同时,人类与机器人在身体结构、运动学约束和执行方式上存在差异,使得视频中的操作经验难以直接转化为机器人可学习、可执行的动作。
因此,在 Vbot 看来,具身智能数据的规模化生产,需要三项能力协同建设:一是拓宽数据来源,让互联网视频(海量通用第三视角视频)成为机器人能够利用的学习资源;二是提升数据的可训练性,将视频中的几何、语义、运动与物理交互信息转化为结构化训练数据;三是降低数据采集门槛,让更多人能够便捷地记录和上传真实操作数据,持续拓展数据来源与场景覆盖。三者相互协同,不仅拓宽机器人学习经验的来源,更打通从真实数据采集、生成处理到机器人训练数据产出的完整链路,为具身智能数据的规模化生产提供支撑。
04. 具身通用数据管线 Vbot Echo:构建端到端数据生产闭环
围绕这一挑战,Vbot 维他动力进一步推出端到端通用数据管线 Vbot Echo,以及配套数据采集应用 Echo App,结合 Exo2EgoPolicy 跨视角生成能力,贯通真实场景采集、云端数据处理与机器人训练数据生成的完整流程。
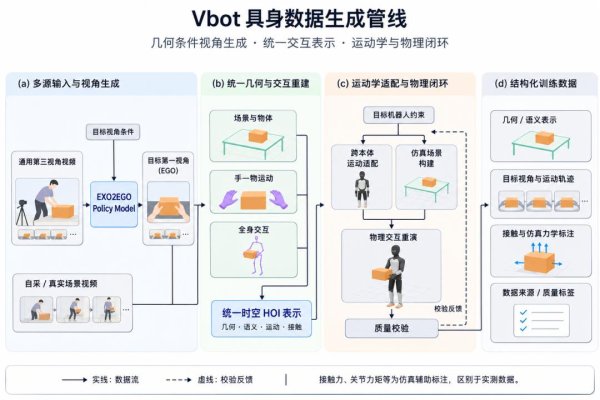
在数据采集端,Echo App 让真实操作经验的获取变得更加简单。相比依赖 UMI 采集装置、遥操作系统等专业设备的数据采集方式,Echo App 将采集过程简化为手机拍摄与上传兼容第一视角 & 第三视角数据采集。 用户无需穿戴专业采集设备,只需将手机放置在操作区域一旁,即可记录真实场景中的操作过程,并上传至云端进行后续处理。数据进入云端后,Exo2EgoPolicy 首先发挥跨视角生成能力,将第三视角记录的人类操作转化为更贴近机器人观测条件的第一视角视频。 通过几何与目标视角条件引导,模型在生成过程中兼顾空间结构、动作时序与人 — 物交互关系,使同一次真实操作示范能够衍生出不同观测视角下的视觉数据,进一步提升原始视频的利用价值。
在此基础上,Vbot Echo 数据管线进一步贯通从几何语义理解到运动学适配与物理验证的完整链路。首先,管线通过动态场景重建、语义理解、人体与物体姿态估计及时间序列对齐,建立统一时空的人 — 物交互(HOI)表示,将场景几何、任务语义、手 — 物运动与全身交互信息关联起来,还原人类操作过程中的空间结构、动作变化与物体交互关系,为后续机器人动作适配提供结构化基础。
同时,Vbot Echo 进一步补全机器人学习所需的运动学与物理交互信息。在运动学层面,结合目标机器人的身体结构与关节约束,通过跨本体运动重定向,将人类的全身与手部动作适配为机器人的关节与末端运动轨迹;在物理层面,结合场景、物体及物性建模,在仿真环境中重演机器人与环境的接触交互,生成接触力、关节力矩等仿真辅助标注。数据由此不止描述 “看到了什么”,更能提供 “机器人如何运动、如何与物体交互” 的训练依据。
与此同时,管线通过物理一致性与质量校验,检查运动稳定性、物体穿透及轨迹跟踪误差,并将校验结果持续回流优化,形成 “生成 — 适配 — 仿真 — 校验 — 优化” 的数据闭环。系统同时保留数据来源与质量标签,明确区分仿真辅助标注与真实测量数据,让同一次人类操作示范最终形成可对齐、可适配、可验证的多层训练数据,为机器人策略学习提供更加完整的数据基础。
具身智能走向通用,必须突破数据供给的边界:让机器人能够学习的经验,从有限的采集现场,扩展到人类每天与真实世界交互的广阔空间。依靠增加设备、场地与采集人员来积累数据,难以持续满足通用机器人对规模与多样性的双重需求。而在人类已经构建的视频世界中,YouTube 平均每天新增超过 2,000 万条视频;TikTok 在 2025 年 11 月披露,每天有超过 1 亿条内容上传。这个持续增长的内容世界,为发掘跨地域、跨场景、跨任务的操作经验提供了巨大空间。具身智能需要打通的,正是这些人类经验通往机器人能力的路径。
Exo2EgoPolicy、Vbot Echo 与 Echo App 的协同,正是 Vbot 为打通这条路径构建的数据基础设施:通过跨视角生成释放通用视频的学习价值,通过结构化处理、动作适配与物理验证,将符合条件的人类操作转化为机器人训练数据,再通过低门槛采集,让更多真实场景与长尾技能持续进入这一体系。这意味着,机器人训练数据的增长,有望从依赖专用采集资源的扩张,迈向对海量人类经验的规模化利用,让数据规模与多样性共同突破。
Vbot 的目标,是从根本上突破具身智能的数据获取瓶颈,让人类经验成为机器人持续进化的源泉。当日常生活与生产实践中不断产生的操作经验,能够持续转化为机器人的学习资源,具身智能就有望获得面向真实世界不断扩展的能力基础 —— 让机器人学习的边界延伸至人类经验的广度,推动通用机器人走进千行百业与日常生活。
(来源: 维他动力)