伽马智能 & TeleAI 联合宇树推出 LocoManiLab,聚焦为人形机器人全身智能建立统一测评框架
项目网站 https://locomanilab.github.io/
论文 https://arxiv.org/abs/2610.30876
If you ask what's the hard problem in the next 10 years, it's getting a mobile robot to do useful manipulation for you. Robert Playter, Boston Dynamics CEO
前波士顿动力 CEO Robert Playter 在一次访谈中曾把移动机器人的下一个十年概括为:让移动机器人完成 “有用的操作”。
这句话背后有一个简单但容易被忽略的变化:机器人不再只是移动到某个位置,而是要自己找到位置、保持平衡、完成操作,并在失败时继续处理任务。
01 / 从动作展示到真正干活
人形机器人的上一阶段,首先要证明的是本体和基本技能可行:机器人可以站立、行走、转身,也可以完成某些抓取和搬运动作。这个阶段的 Demo 很重要,它让人们看到人形形态不再只是实验室里的概念。
但 Demo 的成功往往发生在一个被精心准备过的场景里。物体的位置、光照、相机角度和任务顺序都可能是固定的。机器人完成一次动作,并不意味着它已经掌握了这类任务,更不意味着它能够在新的房间、新的物体和新的初始状态下继续完成。
随着具身智能领域的飞速发展,行业的期望正在从 “机器人能不能做出一个动作”,转向 “机器人能不能在不同条件下稳定完成一件事”。这不是对 Demo 价值的否定,而是对机器人能力提出了更高一层的要求:从展示动作,走向验证能力。
02 / Demo 证明做得到,不等于做得稳、能落地
一段成功视频通常只能说明机器人在某个条件下完成过一次任务。它很难回答几个更接近真实部署的问题:换一个房间后是否仍然成功?换一种物体和摆放方式后是否还能抓取?连续执行多个动作时,前一步的误差会不会传到下一步?如果中途失败,机器人能不能重新规划,还是只能停在原地?
这也是具身智能评测要解决的问题。一个好的 benchmark 不应该只给出一个总成功率,而应该把成功和失败放回任务过程里观察:机器人是否理解了目标,是否找到了合适的站位,是否保持了平衡,是否完成了关键子目标,是否能够在扰动和变化中继续执行。
Demo 展示的是一次结果,benchmark 要测量的是能力边界。
03 / 移动操作为什么是人形机器人的难题
移动操作不是把 “走路” 和 “抓取” 简单相加。对一个固定在桌面前的机械臂来说,任务的核心可能是让末端到达正确的位置;对一个人形机器人来说,它还要决定自己应该站在哪里、身体如何转向、双脚如何配合,以及伸手之后如何保持重心。
任务开始后,机器人面对的也不是一串互不相关的动作。它可能先走到柜子前,再打开柜门;柜门的状态改变后,下一步的抓取位置也会改变;拿到物体后,它还要转身、避开障碍物,并把物体放到新的位置。每个局部动作都可能成功,但整段任务仍然可能失败。
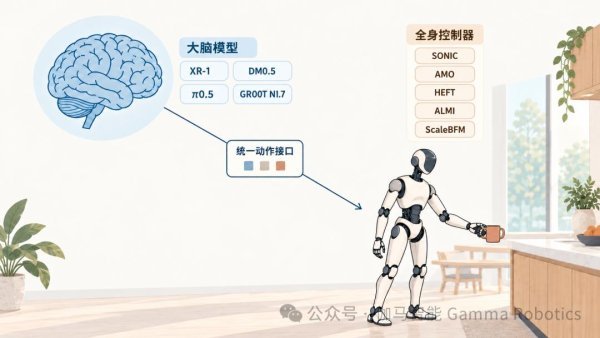
这使得移动操作成为具身大小脑必须面对的难题。上层模型需要理解视觉和语言,决定下一段动作;下层全身控制器则要把这个动作意图变成真实身体能够执行的运动。两者之间的接口、身体的平衡和环境的变化,都会影响最终结果。
04 / 人形机器人需要一套新的考题
已有的具身操作 benchmark 已经推动了抓取、放置和双手协同研究。但当评测对象变成人形机器人,问题边界也随之扩大:评测不再只关注手和物体之间的关系,还要关注整个身体如何进入环境、改变姿态,并在接触过程中保持稳定。
第一,人形机器人评测要求更多的任务种类。相较于双臂操作的抓取、移动、放置,人形机器人的自由度更高,能够完成弯腰、跪地、下蹲等全身协调动作,单一的桌面操作难以衡量人形机器人的全身移动操作能力。
第二,策略和身体执行要能够分开比较。同一个 VLA 或 WAM 换一套全身控制器,可能得到不同的成功率、跌倒率、动作平滑度和功耗。如果不把策略、接口和控制器的关系记录清楚,就无法判断失败究竟来自任务理解,还是来自身体执行。
第三,成功率之外还要记录执行代价。机器人是否摔倒、是否打滑、动作是否平滑、耗费多少机械功率、用了多长时间,这些信息都决定了它距离真实部署还有多远。
换句话说,人形机器人需要的不是一张只回答 “做没做成” 的成绩单,而是一套能够解释 “为什么成功、在哪里失败、下一步应该改哪里” 的考题。
05 / LocoManiLab:把移动操作放进同一套评测框架
LocoManiLab 的出发点很明确:人形机器人移动操作的进展之所以难以比较,不只是因为模型不同,也因为任务、控制器、数据和部署条件经常不同。要真正比较策略能力,就需要把这些因素放进同一个可复查的实验体系。
这套框架覆盖五类家庭空间、13 个场景实例和 234 项任务,其中包括 102 项原子任务与 132 项组合任务。原子任务用于观察走近、开门、抓取和放置等基本能力;组合任务则把多个动作连成更长的任务链,考察机器人能否在移动和操作之间持续衔接。
在策略评测中,12 种 VLA、WAM 使用共同的全身控制条件,重点比较上层策略在同一执行配置下的表现;在控制器评测中,两个代表性 VLA 策略分别接入五套全身控制器,观察相同动作意图经过不同身体执行方式后会产生什么差异。
这种拆分很重要。只比较策略,可以回答谁更擅长理解任务和安排动作;把控制器也纳入比较,才能进一步回答相同的动作意图是否能够被不同的身体稳定执行。
评测还区分了训练分布内、分布外的场景和任务,并加入不同强度的视觉扰动。除了任务成功率,系统还记录足部打滑、跌倒、机械功率、动作变化和完成时间。项目进一步在 Unitree G1 上设计与仿真相近的真实任务,用于观察仿真中的相对表现能否在真机中得到呼应。
06 / 一张成绩单,暴露出什么问题
LocoManiLab 的结果最值得关注的地方,不是某个模型在单一总榜上的名次,而是不同条件下的成绩变化。以 XR-1 为例,它在见过任务上的平均成功率为 80.2%,在未见任务上降到 25.2%,当场景和任务同时变化时进一步降到 8.2%。
这组数字说明,现有模型已经能够在熟悉条件下完成不少动作,但 “会做熟悉的事” 和 “能够迁移到新的事” 之间仍然存在明显距离。对真实机器人来说,后一个问题往往更接近用户真正关心的能力。
成绩单还显示,没有一种策略在所有条件下都占据优势。原子任务、组合任务、视觉扰动和未见场景可能带来不同的排名。与此同时,控制器之间也会在成功率、稳定性和动作代价上呈现不同取舍。
因此,移动操作的评测不能只留下一个 “冠军”。更有价值的结果,是把不同策略和不同控制器的能力分布展示出来,让研究者知道下一步应该补数据、改模型,还是改进身体控制。
07 / 从 Demo 到成绩单,人形机器人的下半场才刚开始
人形机器人的下一阶段,不是继续寻找更复杂的表演动作,而是进入更真实、更连续、更难被剪辑掩盖的任务环境。机器人需要走到目标附近,调整身体姿态,完成操作,处理环境变化,并在出现误差时继续工作或安全停止。
这也是全身移动操作 benchmark 的意义:它不只是给模型排一个名次,而是把机器人做事过程中最容易被忽略的部分显式地测量出来。策略是否理解了任务,身体是否能够稳定执行,换一个环境后还能不能继续工作,都应该有对应的任务和指标。
LocoManiLab 试图建立的,正是这样一套共同的考题。它把数据、策略、控制器和部署连接起来,让 “机器人做过一次” 逐渐转化为 “机器人具备怎样的能力”。
真正值得期待的,不是机器人又完成了一次漂亮动作,而是我们终于能够清楚地知道:它会什么、不会什么,以及距离把事情真正做完还有多远。
(来源:伽马智能)