
随着具身智能从技术验证走向规模化部署,机器人对端侧计算平台提出了更高要求。一方面,VLA(视觉 - 语言 - 动作模型)、多模态模型及世界模型持续演进,模型结构与计算需求不断变化;另一方面,机器人需要在真实环境中实现稳定、低时延的感知、决策与控制。如何让芯片计算能力持续适配模型创新,并降低不同模型、不同机器人产品的重复开发成本,正成为具身智能规模化落地的重要工程挑战。
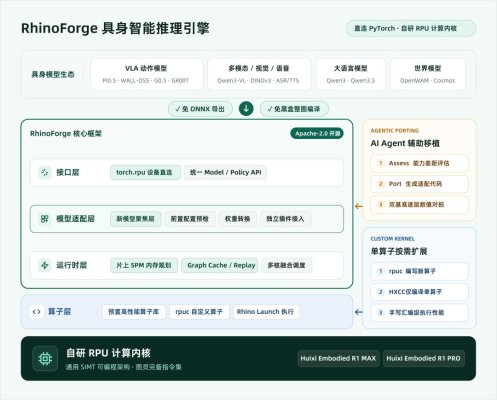
近日,辉羲智能正式开源具身智能推理引擎 RhinoForge。作为自研软硬协同计算平台的重要软件组件,RhinoForge 是一套面向自研 RPU 计算内核的 PyTorch 推理与模型部署框架,目前支持 Huixi Embodied R1 MAX 和 Huixi Embodied R1 PRO 两款具身智能大算力芯片。依托芯片底层通用可编程架构,RhinoForge 支持开发者自主适配模型、扩展计算算子,并将底层优化能力沉淀为可跨模型复用的工程资产。
目前,RhinoForge 已适配 Pi0.5、WALL-OSS、G0.5、GR00T、RhinoVLA、LingBot VLA 2.0 等 VLA 模型,Qwen3-VL、DINOv3、Qwen3-ASR/TTS 等多模态、视觉与语音模型,以及 Qwen3、Qwen3.5 等大语言模型;面向 OpenWAM、Cosmos 等世界模型,同样支持适配。在与具身机器人企业的合作中,RhinoForge 已应用于模型适配与部署优化,帮助开发团队减少重复性底层开发工作,提升模型迁移与迭代效率。
开源链接:https://github.com/HUIXI-AI/RhinoForge
打通 PyTorch 部署路径,支持具身模型自主适配
模型在 PyTorch 中验证通过后,要真正适配到具身智能芯片上,第一步是打通软件入口。不少端侧平台将 “导出 ONNX 静态图 + 整图编译” 作为常用部署通道:对于结构固定的成熟模型,这套路径固然行之有效;但在快速演进的具身场景下,一旦新模型引入导出工具或编译器尚未支持的算子、动态形状或自定义缓存机制,开发者只能改写模型迁就工具链,或者被动等待芯片厂商排期更新。
RhinoForge 将自研 RPU 计算内核直接接入为 PyTorch 可调用的计算设备。对于已适配的模型及支持配置,开发者可沿用熟悉的 PyTorch 代码加载模型、运行推理,省去 ONNX 导出和黑盒整图编译。
遇到新增或缺失的计算操作,开发者也不必等待整套工具链发版,可以自己动手补齐,将用高级语言 rpuc 编写的新算子交给 HXCC 编译,需要编译的只有单个新增算子,而不是整个模型。编译完成后即可接回 PyTorch,直接对照原始 PyTorch 实现逐层定位精度与耗时,把精力集中在新增计算上,实现开发效率提升。
开发者能够自行扩展算子,得益于 Embodied R1 系列芯片的通用 SIMT 可编程计算架构。其采用图灵完备的指令集,从硬件底层为新算子编程提供支撑。
这一设计体现了辉羲智能 “数据闭环定义芯片” 的技术理念:从具身智能真实场景中持续演进的计算需求出发,通过通用可编程架构与软件工具链的协同设计,让芯片不仅能够支持现有模型部署,也具备持续适应算法演进的能力,将模型适配和优化的主动权交还给机器人企业与开发者。
释放端侧推理性能:计算、存储、调度三维确定性调优
对一台连续作业的机器人而言,Demo 跑通只是起点,真正决定真机体验的是能否连续稳定运行。从输入多路相机图像与指令,到输出下一组动作序列,耗时可能消耗在某一步密集计算、片外内存反复搬运或多轮动作去噪的任务调度上。
RhinoForge 围绕端侧小 batch 实时推理,将计算、存储与调度三层深度优化能力融于同一套框架中,充分释放自研芯片性能:
在计算与精度上,开发团队可用高级语言 rpuc 改写耗时热点算子,经 HXCC 编译后,核心算子性能可达到手写汇编水平。同时,框架支持 INT8、FP8、FP16/BF16、INT4、NVFP4 等量化方案,并允许按模块敏感度组合使用。在数据访问上,让高频复用的中间数据尽量驻留在片上,减少与外部内存之间的往返,同时避免运行期动态内存分配带来的碎片与时延波动。在执行调度上,支持执行图缓存与重放,记录首次执行的执行图,后续对满足形状与状态复用条件的推理直接稳态重放,省去逐个提交算子的主机开销。
在辉羲智能研发团队基于 OpenPI 格式的 LIBERO 测试中,视觉 - 语言 - 动作模型 Pi0.5 在 Embodied R1 MAX 芯片上的端到端推理频率达到 12.5 Hz。
把一次性适配变成长期资产,底层能力跨模型复用
模型目录链接:
https://github.com/HUIXI-AI/RhinoForge/blob/main/examples/configs/README.md
面对层出不穷的新模型,如果每一次适配都依赖少数底层专家从头手写,依然难以跟上具身产品的演进速度。衡量一套端侧推理框架的长期价值,不只看当前支持多少模型,更在于接入下一个新模型、适配下一款新本体需要多少时间。
RhinoForge 从两个维度解决持续复用的问题:
第一,通过四层解耦设计,把模型差异与公共底座彻底分开:接口层提供统一的 PyTorch 设备与模型加载入口;模型适配层处理具体模型的配置预检、权重布局转换与推理流程编排,并支持外部团队以独立插件接入、无需修改主仓库;运行时层承载所有模型共用的融合执行框架、片上 SPM 内存规划与执行图缓存重放;算子层提供预置高性能算子库,以及开发者用 rpuc 编写、经 HXCC 编译的扩展算子。接入新模型时,开发者可聚焦差异层级做增量开发,每一次补齐的能力都将留在对应层级,成为后续模型复用的积累。
第二,将专家移植经验产品化,内置面向 AI Agent 的标准化工作流:RhinoForge 进一步将模型移植过程中的工程经验整理为结构化知识库与内置 Agent Skill,为开发者提供模型适配、算子扩展及问题排查等环节的辅助。在已支持的工具与配置条件下,开发者可借助 AI Agent 执行部分标准化操作,由工程师负责关键技术决策、精度验证与结果确认,逐步降低重复性模型迁移工作的工程成本。
RhinoForge 的开源,是辉羲智能持续完善具身智能软硬协同计算平台的重要一步。依托面向具身智能需求设计的通用可编程架构,辉羲智能将芯片底层计算能力转化为开发者可自主使用、持续优化和跨模型复用的工程能力,帮助机器人企业降低模型适配与部署成本,加快具身智能产品的迭代。
面向具身智能规模化部署,辉羲智能将持续推进芯片产品、软件工具链与模型生态的协同演进,通过开放工具链降低开发门槛,并结合真实应用需求持续优化计算平台,与产业合作伙伴共同构建面向具身智能的开发生态,为多场景部署提供长期支撑。
关于辉羲智能
辉羲智能专注于具身智能大算力芯片研发和产业生态建设,为机器人企业提供覆盖芯片、模组、软件工具链与基础模型的全栈算力产品及解决方案。
辉羲智能坚持 “数据闭环定义芯片” 的技术理念,从真实场景出发设计计算架构,推出基于通用可编程架构的高性能 AI SoC 光至 R1 及配套计算平台。同时,公司构建了覆盖模型框架、编译器、算子库等在内的软件体系,通过软硬件协同优化,加速具身智能规模化部署。目前,相关计算产品已应用于工业制造、智慧零售、无人物流、商用餐饮等场景中,并向边缘计算、特种作业等智算场景拓展。
辉羲智能致力于成为全球领先的具身智能计算平台供应商,以卓越计算促进人工智能发展。
(来源:辉羲智能)
资讯评论 (0)
全部评论
暂无评论,来发表你的看法吧