
2026 年 11 月 10 日,在机器人学习大会(CoRL 2026)期间,光轮智能正式发布强化学习仿真环境 RoboFinals RL Environments,旨在为大模型强化学习提供能够持续交互并给出可信物理反馈的仿真环境,提升复杂任务中的策略训练效率与环境迭代能力。
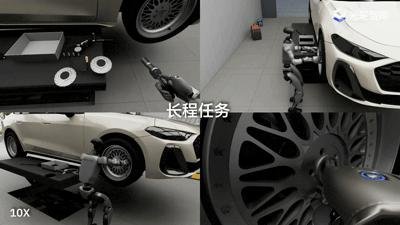
强化学习训练需要大量、持续的交互采样,而真机试错的成本与效率限制了训练规模。因此,能够覆盖多样任务、支持并行采样并提供可靠物理反馈的仿真环境,正成为具身模型研发的重要基础设施。本次发布展示了时长超过 8 分钟的长程仿真任务,将灵巧操作、多阶段流程与可变形物体交互整合在同一工作场景中。前一步操作造成的物体位置、姿态和接触状态变化会延续到后续步骤,让策略在连续交互中学习保持任务进度、调整动作和处理异常。
光轮智能依托 “求解 - 测量 - 生成” 三位一体全栈自研 SimFoundry 仿真底座,AI agent 驱动生成链路,让真实场景与任务得以规模化进入仿真。在这一流程中,光轮智能基于真实场景中的真实任务,进行资产重建、物理建模和任务定义,搭建可交互的仿真环境。SimFoundry 让场景中的关键物体具备相应的物理属性与交互逻辑,支持策略在不同初始状态和操作条件下反复尝试,通过物理交互与任务反馈积累训练经验,为强化学习提供持续的交互采样。
光轮智能推进 Agentic 校准工作流,提出校准方向、比较结果并组织下一轮调整,让关键交互物理真实。例如,软管受到牵拉时的弯曲和摆动,会影响机器人的操作过程。光轮智能通过 Agent 自动迭代调整仿真参数并辅以专家监督,成功减少异常抖动,使软管响应更接近真实,为强化学习提供更可靠的交互反馈。
光轮智能 RoboFinals 正从可复现、可诊断、可对比的工业级规模化评测平台,向支持策略交互的学习环境延伸。其中,RoboFinals RL Env 提供规模化训练的强化学习环境,RoboFinals Benchmark 提供规模化评测能力。两者共享任务语义、场景资产和能力定义,使训练与评测围绕相同的工作要求展开;训练任务、奖励调参过程与独立评测实例则保持区分,为学习效果保留独立的检验依据。
从提供训练经验,到构建交互环境,再到评测与部署反馈,光轮智能将持续建设物理 AI 基础设施。RoboFinals RL Env 将交互训练纳入这一体系,支持模型在反复实践中改进策略,并让能力提升接受真实任务的检验,推动机器人走向更多实际应用。
(来源:光轮智能)
资讯评论 (0)
全部评论
暂无评论,来发表你的看法吧