
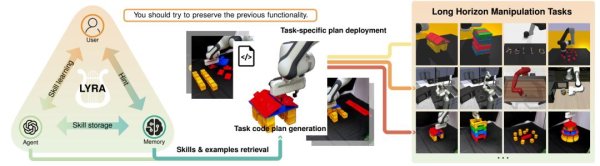
星源智最新成果 LYRA ,是一套面向机器人长时序操作的终身技能学习 Agent 框架。人观察执行结果、指出哪里需要调整,LYRA 就能据此修改技能代码,保存经过验证的做法。下一次面对更复杂的指令,机器人可以调用和组合这些技能。
目前,LYRA 已全面开源,相关论文已被 IEEE Robotics and Automation Letters(RA-L)接收。
LYRA 名称取自 a Lifelong learning code sYnthesis framework for Robotic long-horizon skill Acquisition,即面向机器人长时序技能习得的终身学习代码合成框架。
这项研究也回应了星源智在最初选择大小脑分层架构时就关心的一个问题:当大脑能够规划越来越复杂的任务,机器人靠什么把计划一步步变成行动?
论文:Robotic Ultra-Long-Horizon Manipulation Skills via Human-guided Lifelong Code Generation
开源代码:BAAI-Humanoid/LYRA(需复制打开)
随着 GPT-6 Astra、Claude Fable 等基础模型持续演进,大脑模型能够理解更复杂的指令,规划更长的任务。而小脑模型也在拓展操作范围,提高动作精度和响应速度。两者各有自己的迭代节奏。
星源智技术路线的前瞻性,在于很早就把具身 Agent 作为大小脑分层架构的关键来研究。Agent 把机器人可用的技能和相关经验提供给大脑,按计划调用小脑执行,再把执行结果带回下一轮决策。大脑能规划的任务越长,小脑能执行的操作越多,机器人就越依赖 Agent 在恰当的时候调用恰当的技能,并根据实际进展调整下一步。
星源智最新开源的具身 Agent 工作 LYRA 从一个具体问题切入:机器人怎样把人的一次纠正,转化为今后执行其他任务时也能用上的技能?
在 LYRA 的叠积木实验中,人可以对 “把积木叠起来” 提出更具体的操作细节,比如让上下两块积木的边角对齐。机器人执行后,人观察结果、指出偏差,LYRA 据此修改堆叠技能的代码。等到下一次搭塔,机器人就可以直接调用经过验证的对齐方法。
此外,同一项技能也可以适应新的要求。例如,把搭建位置设为参数,以后换个位置搭塔,系统仍然可以调用同一个堆叠技能。LYRA 将验证过的技能和成功执行的示例存入外部记忆:技能记录具体怎样做,示例记录在什么任务中、怎样调用它。
接到新任务,Agent 检索相关技能和示例,供大脑模型规划。整个过程无需重新训练基础模型。
两块积木怎样对齐,到了搭房子时就成了搭底座的一步。机器人可以调用已有的排列技能,把积木排成底座,再学习怎样识别和放置屋顶。这样,当人提出 “搭一座房子”,系统就能把任务拆成清理桌面、搭底座、装屋顶,分别调用所需的技能。
图 3 展开了这座房子的搭建过程。所用的 12 项技能里,有 5 项沿用此前任务中学到的方法,另外 7 项是为搭房子学的。沿着技能树,可以看到一项熟悉的操作怎样成为更复杂任务中的一步。
搭一座积木房子需要规划二十多个操作步骤。在论文的 Ravens 仿真测试中,LYRA 在这项任务上的成功率达到 80%,同场测试中经过微调的 OpenVLA 和 π₀ 均未完成搭建。LYRA 可以直接调用学过的排列、堆叠等技能,让大脑围绕清理桌面、搭底座和装屋顶来规划整项任务。
从仿真走向真机,LYRA 学到的技能可以部署在不同的具身本体上。团队为 Franka FR3 提供了与仿真环境命名和参数一致的操作接口,使真机能够调用在仿真中学到的技能。面对此前未见的搭建寺庙任务,LYRA 重新组合已有技能,指挥机械臂搭底座、逐层堆叠并封顶。在每次最多五轮纠正的条件下,10 次真机试验中有 6 次完成了搭建。
让机器人在交互中保留经验、扩展技能,是团队持续探索的 Lifelong Learning—— 终身学习路线。早在 2025 年 9 月,LYRA 的相关研究就已公开。
如今,RSI(递归自我改进)受到关注。LYRA 已经在具身场景中探索了其中的一项重要基础:在人类指导下,怎样让上一次交互的反馈,成为机器人下一次学习时可以利用的经验。
对星源智而言,这条路线的意义在于,机器人能力的增长拥有了更多来源。新的模型可以带来更强的理解与推理,任务中的经验也可以通过技能学习留下来,支持后续行动。
Agent 因而成为连接模型能力与任务经验的重要机制。它帮助系统利用已有能力,也为经验积累提供了载体。
回到那座积木房子。机器人已经学会怎样排列底座,但在把屋顶放上去之前,还要考虑眼前的结构:如果落点偏了一点,下面的积木会怎样移动?要决定这一步怎么做,机器人还需要预测动作会怎样改变环境。
此前,星源智已通过 ω-EVA 具身交互世界模型,使得世界模型的预测能力进入机器人行动决策过程:让策略在行动前与自己的后果交互,并利用后果验证和优化动作,使世界模型从被动预测进入行动闭环。
在星源智的具身智能体系中,Agent 研究的是怎样组织机器人已有的技能来完成任务,并通过终身学习,把交互中验证过的做法用于新的任务。世界模型研究则关注动作会怎样改变环境,以及机器人如何依据预测调整行动。这些工作共同服务于机器人在复杂环境中持续完成任务的目标。
在已有研究积累之上,星源智正在进一步建设自己的具身模型技术体系,更多研究成果将陆续发布。
(来源:星源智机器人)
资讯评论 (0)
全部评论
暂无评论,来发表你的看法吧